

dbt v2 : ce qui change vraiment pour les équipes Data
Nicolas Bacher
Data Engineer
DBT ne se contente plus de compiler et d’exécuter du SQL. Il peut désormais mieux le comprendre. Qualité, performance, métadonnées et IA : ce que cela change concrètement pour les équipes Data.
Quand dbt Labs sort une version majeure, le cycle est assez prévisible : une annonce très travaillée, des benchmarks impressionnants et un changelog qu’il faut lire entre les lignes.
Cette fois, le sujet mérite vraiment qu’on s’y attarde. Le moteur change en profondeur, le SQL peut être analysé avant son exécution et les métadonnées du projet deviennent beaucoup plus faciles à exploiter.
Pour une équipe Data, cela touche directement trois sujets que je retrouve régulièrement en projet : la qualité, la performance et la capacité à industrialiser de nouveaux usages, notamment autour de l’IA.
Le vrai changement est dans le moteur
Le passage à un moteur entièrement réécrit en Rust est probablement l’évolution la plus structurante.
Jusqu’ici, le fonctionnement reposait principalement sur le rendu du SQL puis son exécution sur le warehouse. Une nouvelle étape s’ajoute désormais avec le static analysis : le moteur peut analyser le SQL, en comprendre la structure et valider certains éléments avant même qu’une requête ne parte sur la plateforme de données.
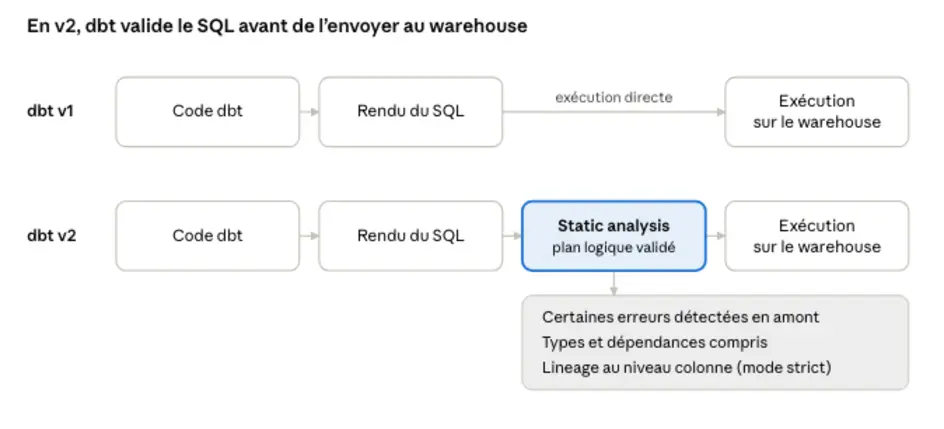
Cela permet notamment de mieux identifier les types, les dépendances et certaines erreurs de SQL. En mode strict, le moteur peut également produire un lineage au niveau colonne. Un Language Server Protocol intégré apporte au passage des fonctions utiles directement dans l’IDE, comme les diagnostics, le go-to-definition ou la complétion des colonnes.
dbt ne se contente plus de faire tourner du SQL. Il commence à comprendre le SQL.
C’est, à mes yeux, le changement le plus important de cette version.
Les performances sont l’effet le plus visible. Sur certains projets très volumineux, DBT Labs rapporte un passage d’environ 20 minutes de parsing à moins d’une minute. D’autres benchmarks montrent également des gains importants sur la compilation. Ces chiffres restent des benchmarks éditeur : ils donnent une tendance, pas une promesse applicable à tous les projets.
La qualité entre plus tôt dans le cycle
C’est probablement la partie que je trouve la plus directement exploitable dans un contexte projet.
Le contrôle du SQL entre dans le workflow avec dbt lint, un linter intégré, compatible avec les règles SQLFluff et capable d’appliquer automatiquement certaines corrections. Les équipes peuvent ainsi faire respecter plus facilement leurs conventions sans ajouter une couche supplémentaire dans la chaîne de développement.
Le changement va au-delà du style.
Certaines erreurs SQL peuvent être remontées avant l’exécution grâce au static analysis. Les contrôles peuvent également porter directement sur le projet avec dbt check, par exemple pour vérifier qu’un modèle est documenté ou qu’un modèle public possède un owner. Ces règles peuvent être exécutées avant tout travail sur le warehouse et intégrées au dbt build.
Les tests évoluent également. Plusieurs data tests peuvent être regroupés afin de réduire le nombre de requêtes exécutées. Certains tests unitaires peuvent aussi être exécutés localement avec DuckDB. Cette possibilité reste expérimentale et nécessite une activation spécifique, mais elle montre bien la direction prise : obtenir un feedback plus rapide tout en limitant le recours au compute du warehouse pour les tests qui peuvent être exécutés localement.
Dans les projets que nous accompagnons, j’y vois surtout un changement de méthode.
Mécanisme | Ce qu’il contrôle |
|---|---|
dbt lint | Le style et les conventions du SQL |
dbt check | Les standards du projet |
| Tests | Les données et la logique métier |
La qualité peut ainsi intervenir beaucoup plus tôt dans le cycle de développement.
Les métadonnées deviennent un actif technique
Le changement est également très intéressant du côté des métadonnées.
Le dbt Information Schema permet désormais d’exposer les informations du projet dans des fichiers Parquet structurés et directement interrogeables. Sur l’un des exemples publiés par dbt, un projet dont manifest.json et catalog.json représentent environ 70 Mo produit un Information Schema d’environ 5 Mo.
L’intérêt dépasse largement la taille des fichiers.
Les données peuvent être interrogées localement avec dbt show --info, ou lues directement avec des outils compatibles Parquet comme Pandas ou Polars. Les informations disponibles s’enrichissent au fil du cycle :
Étape | Ce qu’elle ajoute à l’Information Schema |
|---|---|
| Parsing | Les métadonnées de base |
| Compilation | Les types de colonnes et, en static analysis strict, la lineage au niveau colonne |
| Run | Les résultats d’exécution |
Les métadonnées du projet deviennent une donnée exploitable.
Et c’est là que l’IA devient intéressante
Je ne présenterais pas cette release comme une « version IA ». Le moteur ne fournit pas à lui seul un agent autonome capable de piloter un projet Data de bout en bout.
En revanche, plusieurs briques se combinent de manière intéressante.
- Agent Skills : elles permettent de transmettre à un agent des instructions réutilisables à travers des fichiers
SKILL.md. Une équipe peut y définir ses conventions et ses méthodes de travail, puis les distribuer via le projet ou des packages dbt. Les agents compatibles travaillent alors avec un cadre commun au lieu de repartir de zéro à chaque intervention. - dbt Wizard : il va plus loin en exploitant le contexte du projet pour proposer des modifications sur les modèles, les tests ou la documentation.
Le workflow que j’imagine ressemble à ceci :
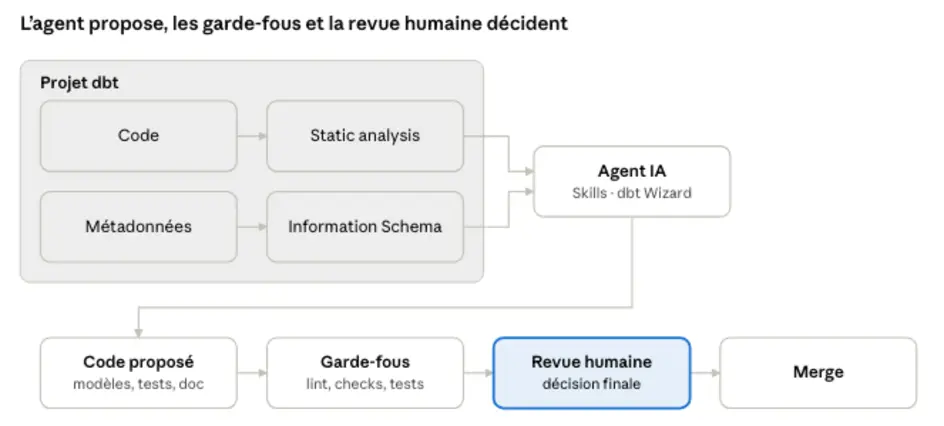
L’intérêt n’est donc pas de demander à un agent de « faire du dbt ». Il s’agit plutôt de lui donner suffisamment de contexte pour qu’il puisse prendre en charge certaines tâches répétitives tout en respectant les règles du projet.
Générer un modèle à partir de spécifications métier, proposer un refactoring, créer des tests simples, compléter une documentation ou aider à analyser un incident sont des cas d’usage crédibles.
La responsabilité de la production reste humaine.
Les permissions, la séparation des environnements, la gestion des données sensibles et la validation des changements relèvent toujours de la gouvernance de la plateforme.
Performance et coûts : mesurer plutôt que promettre
Le passage à Rust peut réduire fortement les temps de parsing et de compilation, surtout sur les projets volumineux. Pour autant, je déconseille de partir d’un benchmark générique pour estimer un gain.
La taille du projet, la structure du DAG, les dépendances et le mode d’exécution jouent tous sur le résultat. Le bon indicateur reste celui que l’on mesure sur son propre environnement.
Il faut également distinguer le nouveau moteur de dbt State, une capacité distincte devenue disponible en GA en parallèle de cette nouvelle génération.
Nouveau moteur | dbt State | |
|---|---|---|
| Principe | Parser et compiler plus vite, analyser le SQL | Éviter de reconstruire ce qui n’a pas changé |
| Fonctionnement | Moteur réécrit en Rust avec static analysis | Compare le code des modèles et les métadonnées du warehouse pour décider quels nœuds construire, ignorer, réutiliser ou différer |
| Gain rapporté par dbt Labs | Parsing d’environ 20 min à moins d’1 min sur certains projets | 15 à 30 % de compute économisé en moyenne chez les premiers utilisateurs, avec des cas plus élevés |
Pour moi, le sujet performance ne se résume donc pas à « dbt est plus rapide ». Il faut regarder le coût complet du workflow : compute, durée des CI/CD, temps d’attente des développeurs, incidents, retraitements et maintenance.
Sur une plateforme qui exécute des centaines ou des milliers de modèles plusieurs fois par jour, ces écarts deviennent rapidement concrets.
Une architecture plus ouverte, avec des limites
La couche de connexion évolue également avec ADBC et Apache Arrow. Le moteur est distribué sous la forme d’un binaire autonome, sans runtime Python à maintenir pour son exécution.
Côté plateformes, la couverture progresse rapidement. À date, les principaux adapters disponibles en GA concernent Snowflake, BigQuery, Databricks, Redshift et DuckDB. Spark est disponible en bêta côté CLI et ClickHouse en beta privé. La couverture continue d’évoluer, avec des différences possibles entre l’usage local et dbt Platform.
Cette évolution ouvre des architectures plus portables, mais elle ne fait pas disparaître les spécificités de chaque moteur.
Les dialectes SQL, les fonctionnalités propres à chaque plateforme, les modèles de sécurité et les outils périphériques continuent de peser dans les choix d’architecture.
L’ouverture est réelle. La portabilité, elle, reste à construire.
Faut-il migrer ? Je commencerais par mesurer
Une migration vers dbt v2 n’est pas simplement une mise à jour de version.
Le langage devient plus strict et certaines configurations ou comportements qui passaient jusque-là sans erreur peuvent désormais être bloquants. Les packages, macros, configurations, tests et intégrations existantes doivent donc être vérifiés avant une mise en production.
La bonne démarche me semble être de commencer par un périmètre représentatif et de mesurer quelques indicateurs :
- Temps de parsing et de compilation ;
- Durée des CI/CD ;
- Erreurs détectées avant exécution ;
- Consommation de compute ;
- Couverture des tests ;
- Effort de maintenance.
Cette approche permet de construire un business case sur des résultats observés. Le gain peut venir du compute, mais aussi du temps de développement et de la diminution de la charge opérationnelle.
Pour les programmes IA, cette approche est encore plus importante. Des données mal documentées ou difficiles à fiabiliser créent rapidement une dette opérationnelle : retraitements, validations manuelles, difficultés à expliquer les résultats ou ralentissement de l’industrialisation.
À l’inverse, des transformations versionnées, testées, documentées et traçables constituent un socle réutilisable pour la BI, les APIs et les futurs workflows avec des agents.
En conclusion
Pour moi, le principal intérêt de cette nouvelle version est moins dans ses nouvelles fonctionnalités que dans l’évolution du moteur : dbt ne se contente plus d’exécuter du SQL, il peut désormais mieux le comprendre, le valider et exploiter les métadonnées du projet.
- Rust améliore les performances.
- Le static analysis apporte une compréhension plus fine du SQL.
- Le lint, les checks et les tests déplacent la qualité plus tôt dans le cycle.
- L’Information Schema transforme les métadonnées en un actif exploitable.
- L’ensemble crée également un contexte beaucoup plus riche pour les workflows assistés par IA.
dbt v2 ne transforme pas une plateforme Data en plateforme IA. Il renforce certaines des fondations nécessaires pour construire des produits Data plus fiables, plus maintenables et plus automatisables.
Chez Claranet, je regarderais donc moins la question « faut-il passer en v2 ? » que celle-ci :
Sur quel périmètre pouvons-nous tester ces nouvelles capacités, mesurer leur impact et décider ensuite de leur généralisation ?